OmniVoice: نموذج يحوّل النص إلى صوت مع دعم إستنساخ الأصوات
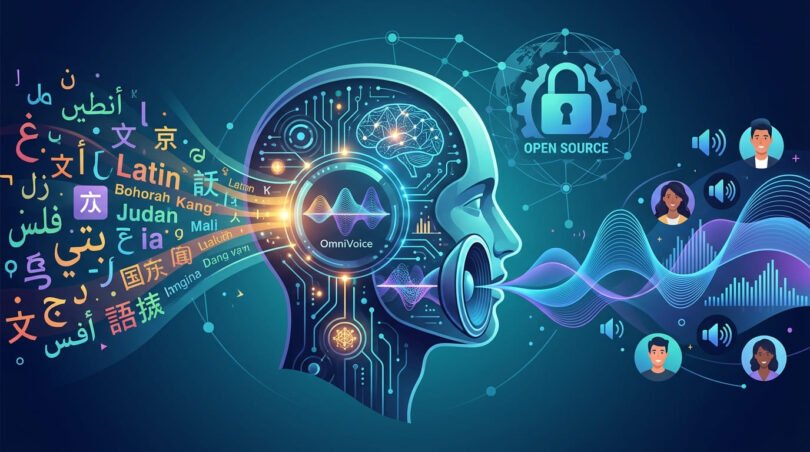
لم تعد نماذج تحويل النص إلى صوت تقتصر على قراءة جمل قصيرة بصوت آلي. مشروع OmniVoice مفتوح المصدر يقدّم نموذجاً متعدد اللغات لتوليد الكلام، مع استنساخ صوت من عينة قصيرة، وتصميم صوت جديد بالاعتماد على وصف مكتوب، وإضافة تعبيرات مثل الضحك والتنهدات داخل النص. والأهم للمطورين أن تشغيله يمكن أن يتم محلياً عبر Python أو واجهة ويب، بدلاً من إرسال كل التسجيلات إلى خدمة سحابية.
الخلاصة السريعة: OmniVoice خيار قوي لمن يريد تجربة تحويل النص إلى صوت واستنساخ الأصوات محلياً. توثيق المشروع يذكر دعماً لـ 646 لغة، بينما يلخّص README الميزة بعبارة «أكثر من 600 لغة». ومع ذلك، تختلف الجودة والاستقرار حسب اللغة والعتاد ووضع التوليد المستخدم.
يأتي المشروع بترخيص Apache 2.0، ما يجعله قابلاً للدراسة والتعديل والتوزيع وفق شروط الترخيص. لكن ترخيص الكود لا يلغي مسؤولية المستخدم عن الحصول على موافقة أصحاب الأصوات وعدم استخدام الاستنساخ في انتحال هوية أشخاص حقيقيين.
مقالات ذات صلة: يمكنك أيضاً قراءة أفضل 15 موقع تحويل النص إلى صوت احترافي مجانا وشرح تشغيل نموذج ذكاء اصطناعي محلياً.
ما هو OmniVoice؟
OmniVoice هو نموذج Zero-shot Text-to-Speech، أي إنه يستطيع توليد كلام بصوت مرجعي أو وصف صوتي من دون تدريب نموذج منفصل لكل متحدث. يحمّل المطور النموذج من مستودع المشروع، ثم يمرر النص وبعض الخيارات إلى واجهة التوليد. وتشير الوثائق إلى أن النموذج مبني على معمارية بأسلوب نموذج لغة انتشاري، مع تركيز على الجمع بين الجودة وسرعة الاستدلال.
وتضم قائمة اللغات الرسمية 646 لغة، مع معرفات خاصة بكل لغة ورمز ISO وبيانات عن ساعات التدريب. كما تظهر في القائمة لغات ولهجات عربية متعددة، مثل العربية المصرية والعربية الخليجية والعربية الحجازية، إلى جانب لغات عالمية ومحلية كثيرة. هذا الاتساع يجعل المشروع مثيراً للاهتمام للتطبيقات التي تحتاج إلى أصوات متعددة اللغات، لكنه لا يعني أن النتيجة ستكون متساوية الجودة في كل لغة.
Free.ai: أكثر من 477 أداة ذكاء اصطناعي في منصة واحدة مجاناً
استنساخ الصوت من عينة قصيرة
في وضع Voice Cloning يمرر المستخدم ملفاً صوتياً مرجعياً، ويمكنه إضافة النص الذي نُطق في التسجيل. وتوصي وثائق المشروع بعينة مدتها بين 3 و10 ثوانٍ، مع تفضيل أن تكون لغة العينة مماثلة للغة النص المستهدف للحصول على نطق أكثر طبيعية. وإذا اختلفت اللغتان فقد ينتقل أثر اللهجة من لغة العينة إلى الكلام الجديد.
تنبيه مهم: استخدم عينات صوتية تملك حق استخدامها أو حصلت على موافقة صاحبها. لا تجعل ميزة استنساخ الصوت وسيلة لانتحال شخصية أو نشر تسجيلات مضللة.
ويمكن حفظ مطالبة الاستنساخ الصوتي بعد إنشائها وإعادة استخدامها في جلسات لاحقة، بدلاً من إعادة تحليل الملف المرجعي في كل مرة. هذه الميزة مفيدة عند بناء خدمة تعليق صوتي أو مساعد صوتي يحتاج إلى صوت ثابت عبر عدة طلبات.
تصميم صوت جديد من وصف مكتوب
لا يشترط OmniVoice ملفاً صوتياً في وضع Voice Design. يكفي وصف خصائص المتحدث، مثل الجنس والعمر ودرجة الصوت واللهجة أو أسلوب الهمس. ويمكن الجمع بين أكثر من سمة في التعليمات نفسها، مثل: صوت نسائي، نبرة منخفضة، ولهجة بريطانية.
توضح الوثائق أن استنساخ الصوت هو الوضع الأكثر استقراراً، بينما دُرّب تصميم الصوت بصورة أساسية على بيانات صينية وإنجليزية. لذلك قد تتفاوت النتائج عند استخدام تصميم صوتي مع لغة قليلة الموارد أو مع أوصاف دقيقة جداً.
أصوات تعبيرية وتحكم في النطق
من النقاط العملية في OmniVoice إمكانية إدخال رموز غير لفظية داخل النص. فعلى سبيل المثال، يمكن استخدام [laughter] لإضافة ضحكة أو [sigh] لإضافة تنهد. وتذكر الوثائق رموزاً أخرى للتعبير عن المفاجأة والسؤال والتأكيد وعدم الرضا.
كما يوفر المشروع أدوات للتحكم في النطق. ويمكن للمطور استخدام تمثيل صوتي مناسب لبعض الكلمات، أو تمرير نطق مخصص عند الحاجة إلى قراءة أسماء وعلامات تجارية ومصطلحات يصعب على النموذج نطقها بالطريقة المطلوبة.
- تعليق صوتي: إنتاج نسخ بلغات متعددة من النص نفسه.
- مساعد صوتي: بناء صوت مخصص مع الحفاظ على نبرة ثابتة.
- التعليم والألعاب: إنشاء حوارات وتفاعلات أكثر تعبيراً.
- إتاحة المحتوى: تحويل المقالات والمواد التعليمية إلى صوت.
Concat: بديل CapCut للكمبيوتر والهواتف مجاني ومفتوح المصدر
طريقة تثبيت OmniVoice وتشغيله محلياً
يوفر المشروع حزم تثبيت عبر PyPI ومصدر GitHub، مع دعم لبيئات pip وuv. بعد إعداد Python وPyTorch المناسبين للبطاقة الرسومية أو جهاز Apple Silicon، يمكن تثبيت الحزمة بالأمر التالي:
pip install omnivoiceولتشغيل الواجهة المحلية التفاعلية، يقترح README الأمر التالي:
omnivoice-demo --ip 0.0.0.0 --port 8001كما يمكن تجربة النموذج من خلال مساحة Hugging Face الرسمية أو دفتر Google Colab المرتبط في المستودع. ويجب الانتباه إلى أن تنزيل النموذج وتشغيله يحتاجان إلى موارد تختلف حسب طريقة الاستخدام، لذلك لا ينبغي افتراض أن كل الأجهزة ستقدم السرعة نفسها.
للمطورين: يذكر README أن زمن الاستدلال قد يصل إلى RTF يبلغ 0.025، أي نحو 40 مرة أسرع من الزمن الحقيقي في إعدادات وعتاد مناسبين. هذه قيمة مرجعية من المشروع وليست ضماناً للأداء على كل جهاز.
هل OmniVoice بديل عملي للخدمات السحابية؟
الإجابة تعتمد على الأولوية. التشغيل المحلي يمنح المطور سيطرة أكبر على الملفات الصوتية، ويقلل الاعتماد على واجهة برمجة مدفوعة، ويفتح المجال لتخصيص سير العمل. في المقابل، يحتاج المستخدم إلى إعداد بيئة Python وتنزيل النموذج وتوفير عتاد مناسب، وقد يتطلب إصلاح بعض المشاكل المرتبطة بالذاكرة أو توافق إصدارات PyTorch.
لذلك يناسب OmniVoice المطورين وصنّاع الأدوات الذين يريدون تجربة تقنية قابلة للتخصيص، بينما قد تظل الخدمة السحابية أسهل لمن يحتاج إلى API جاهزة وحسابات استخدام ودعم تشغيلي دون إدارة النموذج محلياً.
في النهاية يوفر لك OmniVoice حزمة متقدمة في مشروع مفتوح المصدر واحد: تغطية لغوية واسعة، واستنساخ صوت من عينة قصيرة، وتصميم صوت بالوصف، وتوليد تعبيري مع تحكم في النطق. قوته الأساسية للمطورين هي إمكانية التشغيل المحلي والاطلاع على الكود، لكن جودة النتيجة وسرعة التوليد تتأثران باللغة والعتاد ووضع الاستخدام. إذا كنت تبني أداة صوتية أو تريد اختبار إمكانات تحويل النص إلى كلام بعيداً عن الاشتراكات، فالمستودع نقطة مناسبة للبدء.